Microsoft, karar puanlama modeli Decision-1'i yayınladı: Qwen3.5-9B üzerine kurulu, milyon token 0,042 dolar

*Yukarıdaki butona tıkla ve ekle. Yapay zeka gelişmelerini Google’da her zaman üstte gör.
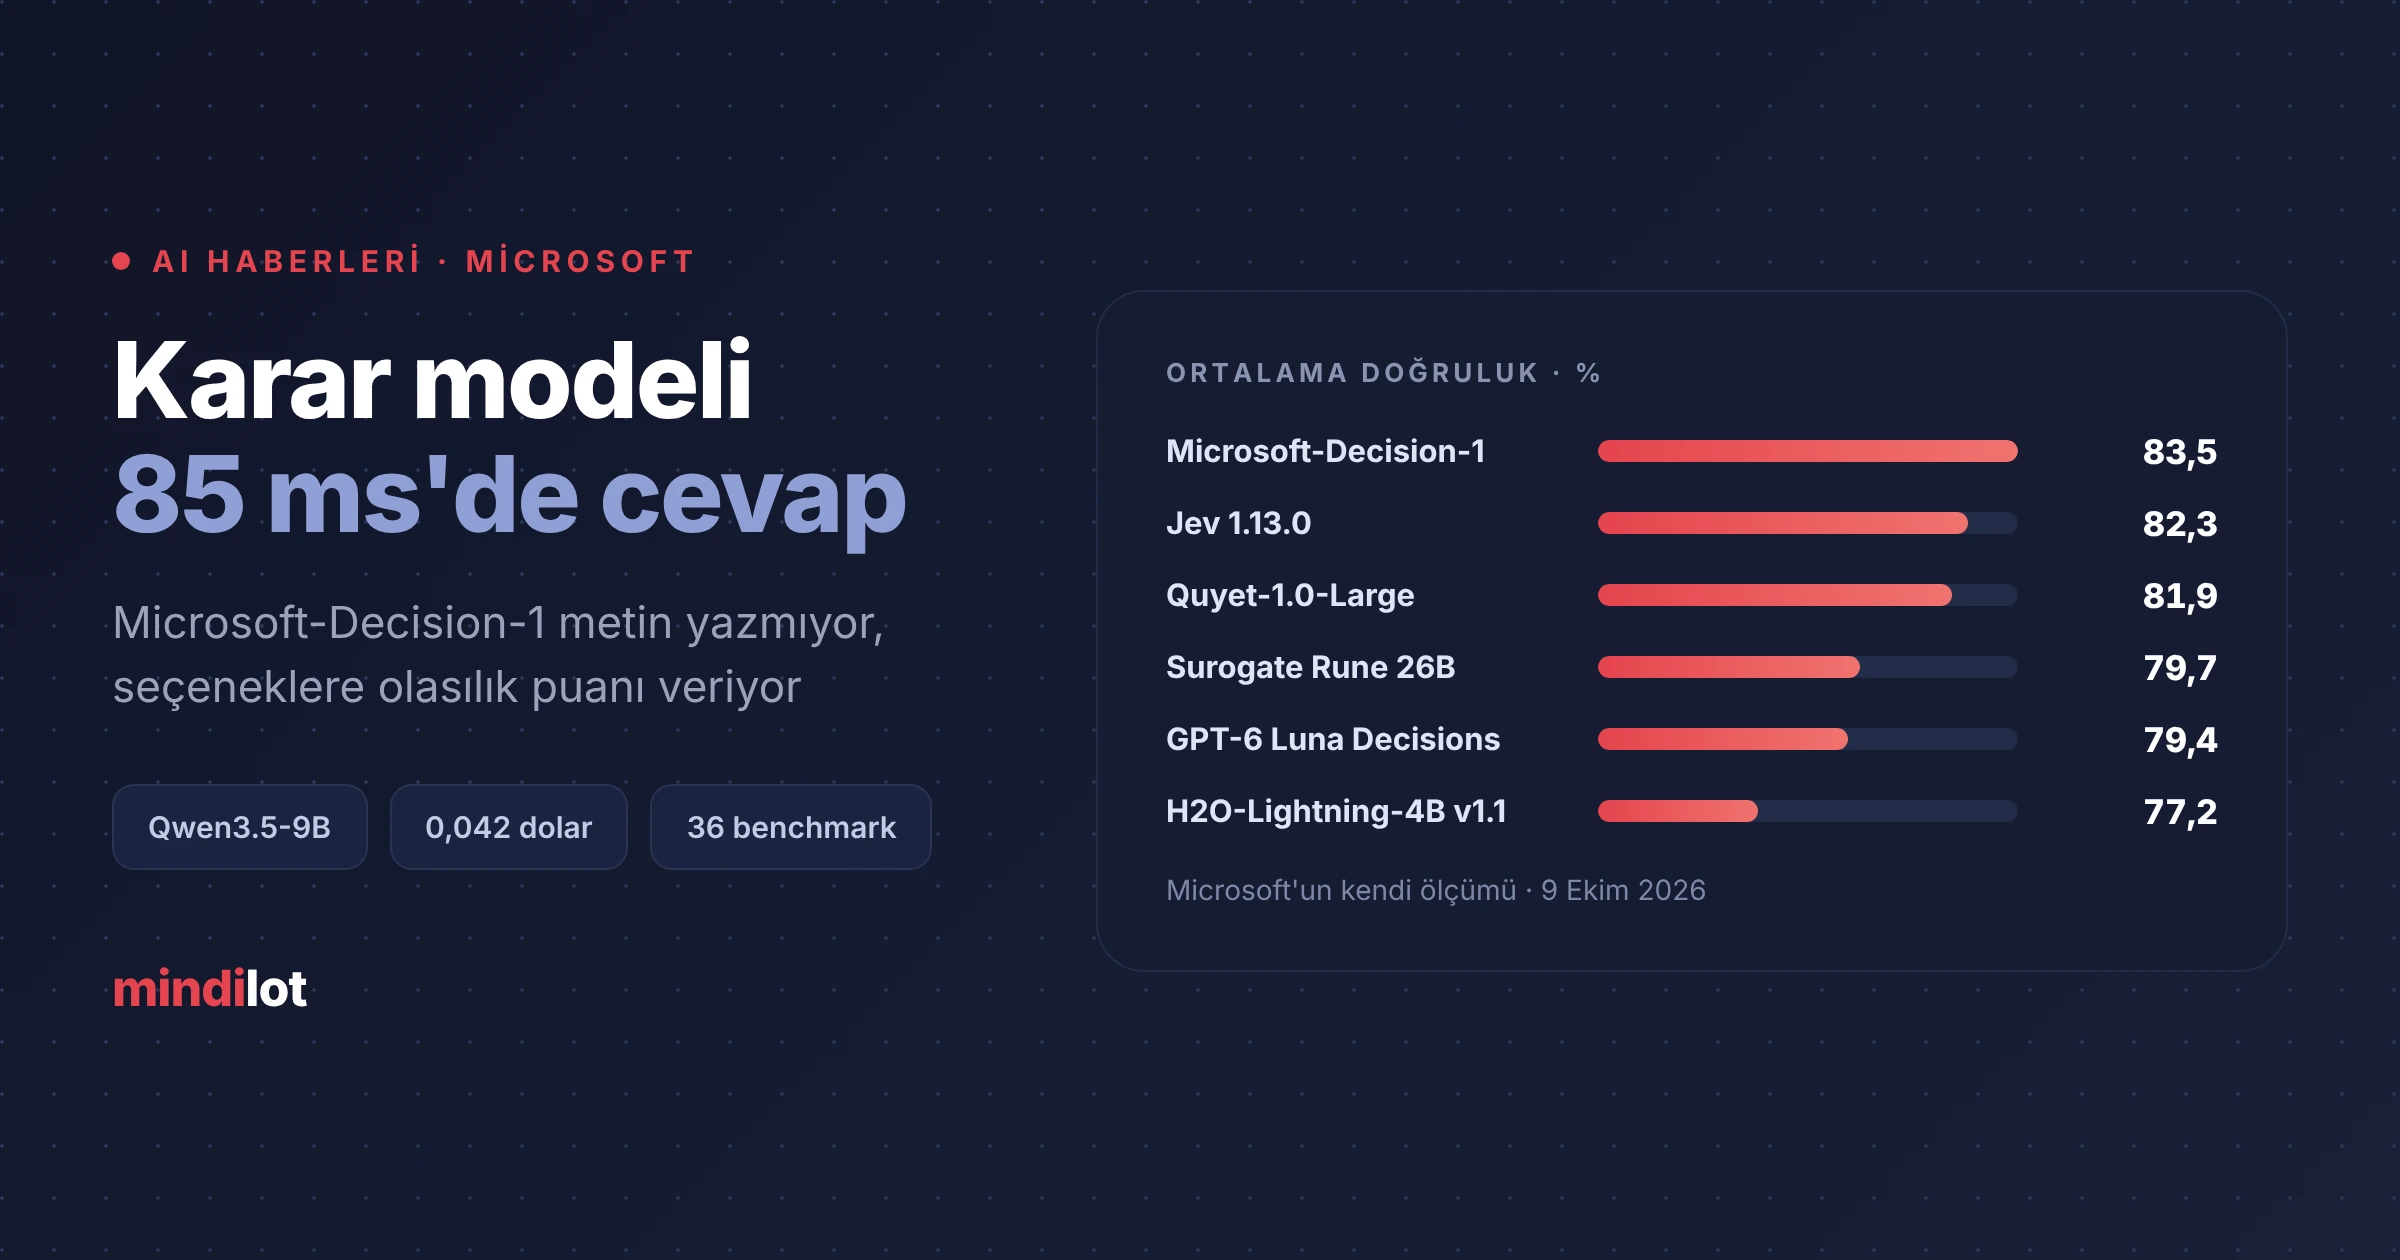
Microsoft, hızlı karar puanlaması için tasarladığı Decision-1 modelini duyurdu. Model metin üretmiyor; sabit bir seçenek kümesinin her birine kalibre edilmiş olasılık puanı döndürüyor. Microsoft bunu LLM'lerden ayrı bir 'karar modeli' kategorisi olarak sunuyor.
Microsoft, 9 Ekim'de hızlı karar puanlaması için tasarladığı Microsoft-Decision-1 modelini duyurdu. Model, metin üretmek yerine sabit bir seçenek kümesinin her birine kalibre edilmiş olasılık puanı döndürüyor; yönlendirme, sınıflandırma, doğrulama ve ajan kontrolü için yapılmış. Microsoft'a göre 36 kıyaslama testinde en yüksek doğruluğu aldı ve en hızlısı çıktı. Şirket bunu yeni bir kategori olarak sunuyor: LLM'ler metin yazar, karar modelleri yazılımın doğrudan işleyebileceği çıktı verir.
Rakamlar ne diyor?
Microsoft-Decision-1, şirketin yaklaşık 150.000 sorudan oluşan 36 benchmarki Modelin yeteneğini ölçmek için kullanılan standart test seti. karşılaştırmasında %83,5 ortalama doğruluk aldı; ikinci sıradaki Jev 1.13.0 %82,3'te kaldı. Hız tarafında model 85 ms p50 latencyiBir isteğe yanıt gelene kadar geçen süre. ile ölçüldü: Microsoft'a göre hızda ikinci olan H2O-Lightning-4B v1.1'den 2,5 kat, GPT-6 Sol'dan 35 kat daha hızlı. Fiyat milyon girdi token'ı başına 0,042 dolar, çıktı ücretsiz. Temel model ise Alibaba'nın açık ağırlıklı Qwen3.5-9B'si.
Neden ayrı bir kategori?
Bir LLM'e "bu destek talebi hangi ekibe gitmeli" diye sorduğunda sana bir cümle yazar. Karar modeli ise doğrudan "A ekibi %87, B ekibi %11" gibi bir olasılık dağılımı döndürüyor, yazılım bunu olduğu gibi işleyebiliyor. Model yes/no, çoktan seçmeli ve derecelendirme formatlarını destekliyor; AI cevaplarını ve ajan eylemlerini rubriğe göre puanlayarak LLM-as-a-JudgeiBir AI cevabının kalitesini başka bir modelin puanlaması. işini de görebiliyor. Karar modellerinin hangi işte işe yaradığını ayrıntılı rehberimizde anlattık.
İki çekince
Birincisi, ağırlıklar indirilemiyor; model yalnız Microsoft Foundry ve OpenRouter üzerinden kullanılıyor ve bütün kıyaslama sonuçları Microsoft'un kendi ölçümü. İkincisi, doğrulukta birinci ama calibrationiModelin verdiği olasılığın gerçek isabet oranıyla ne kadar örtüştüğü. puanında 92,2 ile Jev'in 93,7'si ve Quyet-1.0-Large'ın 93,1'inin gerisinde. "En doğru seçenek" ile "puanın gerçeği yansıtması" aynı şey değil.
Karar modeli kategorisini ciddiye alıyorum, çünkü ajanların asıl sorunu akıllı olmamaları değil, ucuz ve tekrarlanabilir karar verememeleri. Buna rağmen Decision-1'i bugün üretime koymam: kıyaslamaların hepsi Microsoft'un kendi ölçümü. Küçük bir yönlendirme işi için fiyatı cezbedici.