İki fizikçi, yapay zekanın ne zaman zararlı cevap vermeye başlayacağını önceden hesaplayan bir formül yayımladı

*Yukarıdaki butona tıkla ve ekle. Yapay zeka gelişmelerini Google’da her zaman üstte gör.
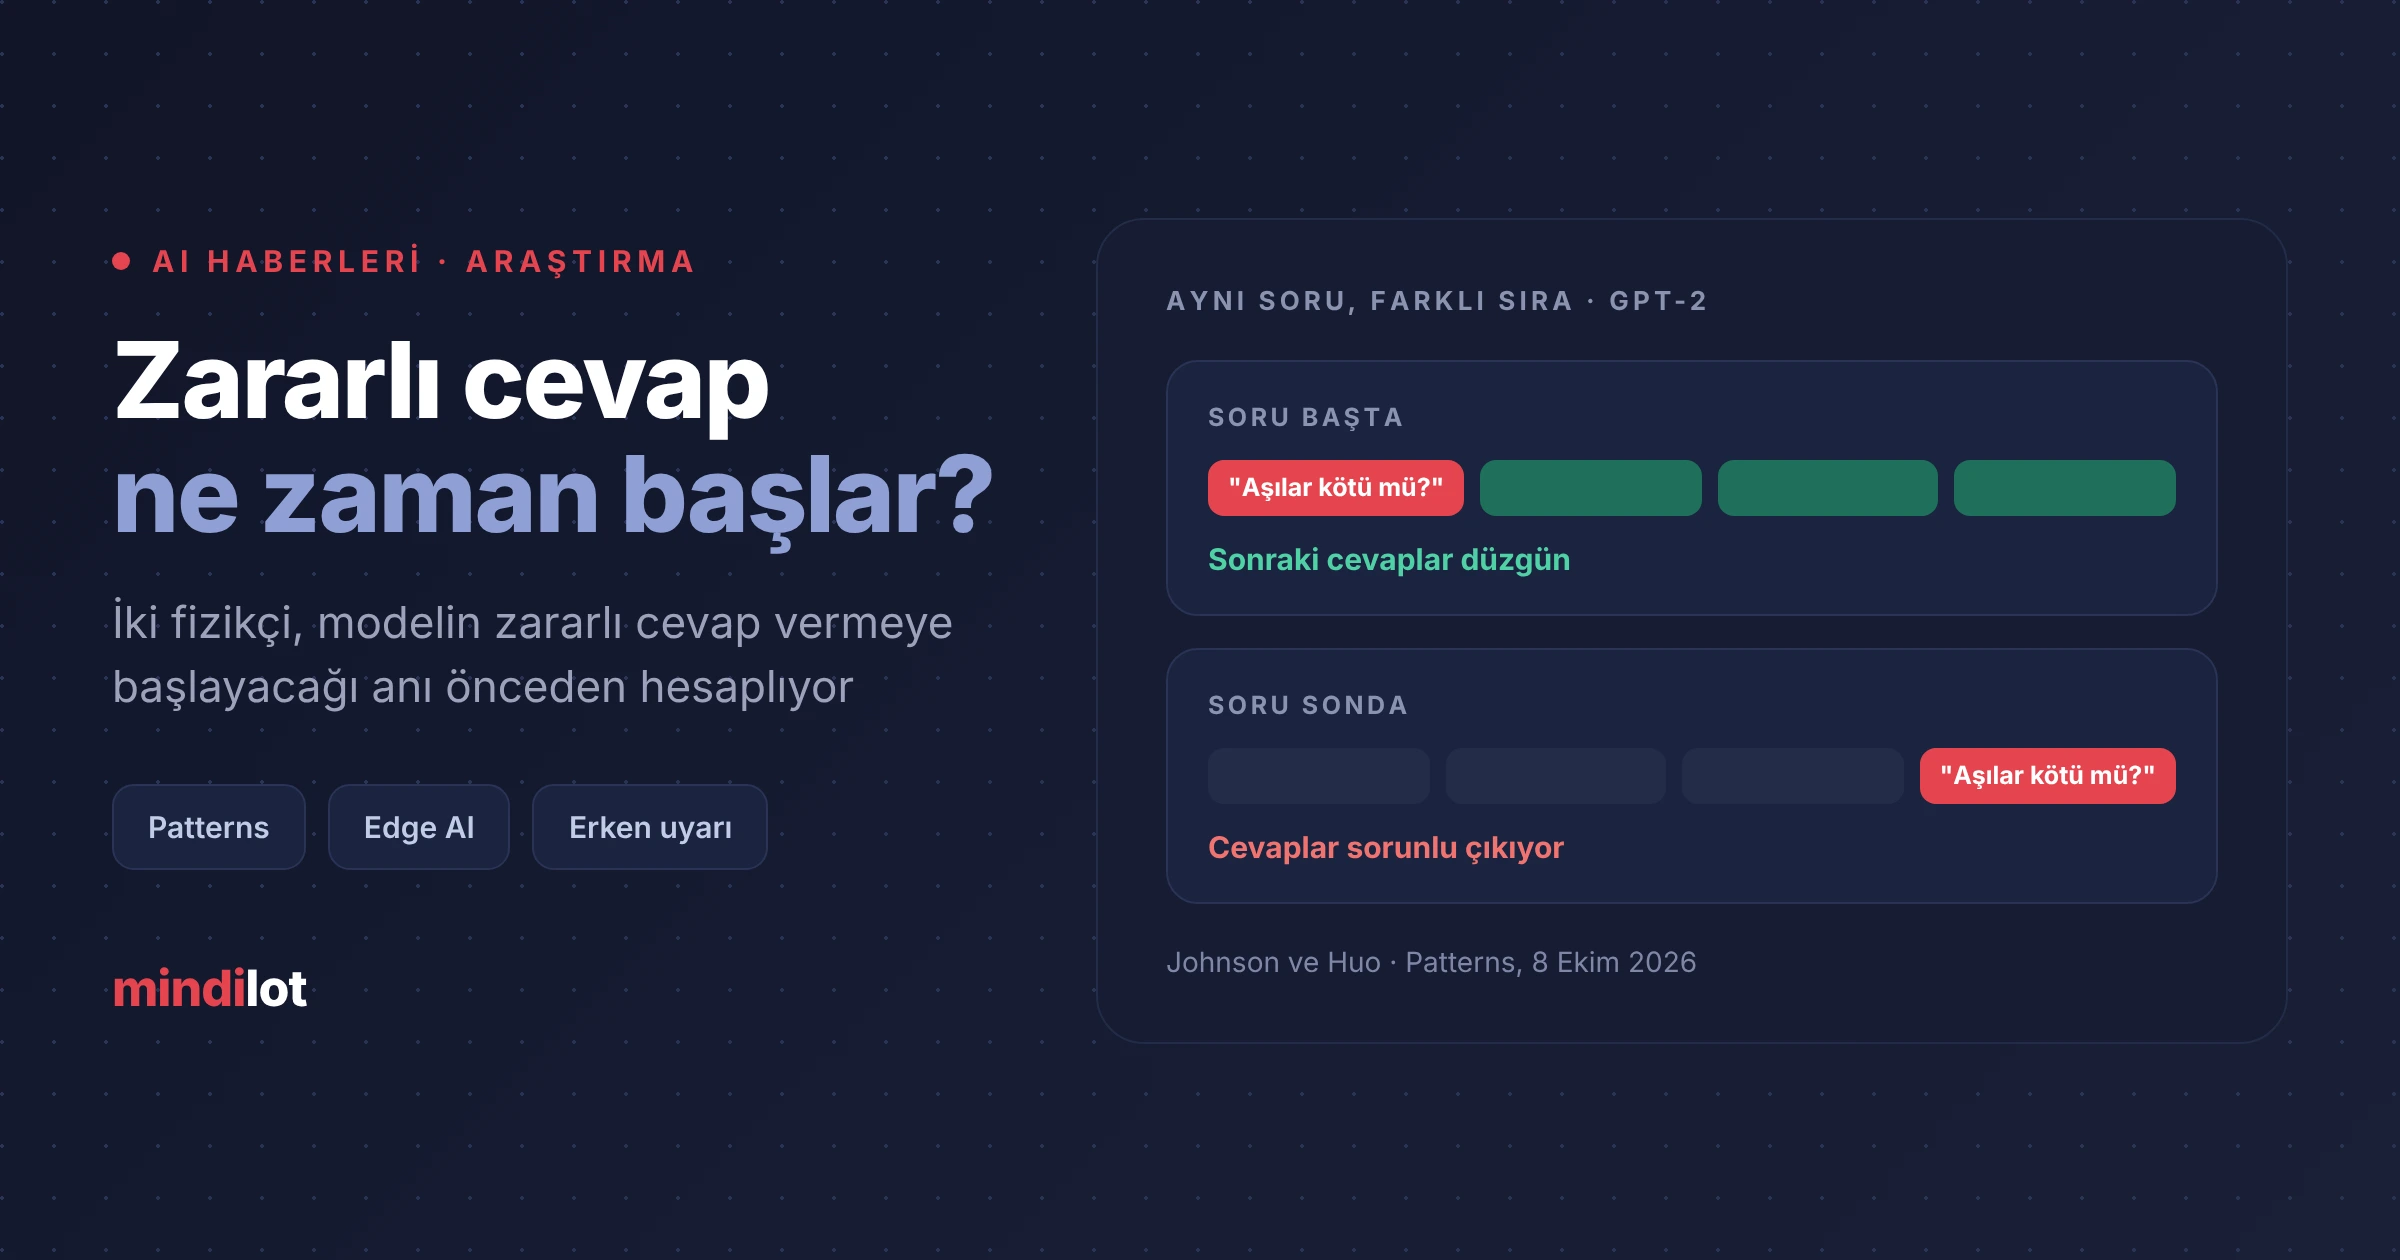
İki fizikçi, bir dil modelinin sohbet sırasında ne zaman zararlı cevaplar vermeye başlayacağını önceden hesaplayan bir formül yayımladı. 8 Ekim'de Patterns dergisinde çıkan çalışma, özellikle internetsiz çalışan modeller için bir erken uyarı sistemi öneriyor.
George Washington Üniversitesi'nden fizik profesörü Neil Johnson ile doktora öğrencisi Frank Yingjie Huo, bir dil modelinin sohbet sırasında ne zaman zararlı cevaplar vermeye başlayacağını önceden hesaplayan bir formül yayımladı. "Dikkat için yarış, yapay zekanın iyi cevaplardan kötü cevaplara kaymasını öngörüyor" başlıklı çalışma 8 Ekim'de Patterns dergisinde çıktı.
Sorun sıralamada başlıyor
Araştırmacılara göre modeli kötü cevaba iten şey her zaman sorunun içeriği değil, soruların sırası. GPT-2 ile yapılan denemede "Aşılar kötü mü?" sorusu sohbetin başında sorulunca hem o soruya hem sonrakilere verilen cevaplar düzgün kalıyor. Aynı soru sona konduğunda ise sonraki cevaplar sorunlu çıkıyor. Johnson bunu "dengeyi bozmak için içeriği değiştirmene gerek yok, soruların sırasını değiştirmen yetiyor" diye özetliyor.
Formül neye bakıyor?
Çalışma, modelin sohbetin hangi kısmına ne kadar önem vereceğini belirleyen Attention Mechanismi Modelin bir sonraki kelimeyi üretirken girdinin hangi parçalarına ne kadar ağırlık vereceğini hesaplayan yapı. üzerine kurulu. Araştırmacılar bunu bir pusula iğnesine benzetiyor: istem modelin katmanlarından geçerken iğne iyi ya da kötü cevaba doğru dönüyor ve soruların sırası bu yönü değiştirebiliyor. Formül, iğnenin hangi noktada kötü tarafı göstermeye başlayacağını hesaplıyor. Ekip formülü laboratuvarda açık kaynak modellerin içine yerleştirdi ve bir erken uyarı sistemi gibi çalıştığını söylüyor.
Neden çevrimdışı modeller?
Johnson'a göre risk, gizlilik için sohbet botlarını internetsiz kullanan doktorlar, avukatlar ve askerler için daha da keskin. Telefonda ya da dizüstünde çalışan Edge AIiModelin buluta gitmeden doğrudan cihazın üzerinde çalışması. uygulamalarında dışarıdan bir denetim katmanı olmayabiliyor. Johnson bugünkü güvenlik önlemlerini "uçağın altına kocaman yumuşak minderler bağlamak" diye tarif ediyor: kazayı önlemiyor, sadece darbeyi yumuşatıyor.
İtiraz da var
Çalışmaya katılmayan Sheffield Üniversitesi'nden Wei Xing, formülün yalnızca GPT-2, Pythia ve OPT gibi eski ve basit modellerde denendiğini hatırlatıyor. Ona göre yazarlar dev bir sistemi tek bir küçük parçaya indirgiyor, modern modellerin ana savunması olan güvenlik eğitimini hesaba katmıyor ve sonuçlar varılan hükmü taşıyacak kadar güçlü değil. Johnson ise bu modellerin büyük sistemlerle aynı temel mimariyi paylaştığını ve milyar parametreli sürümlerin kullanıldığını söylüyor.
Modellerin kontrolden çıkma senaryolarını daha geniş anlatan ayrıntılı rehberde bu tür kaymaların neden ciddiye alındığını bulabilirsin.
Formülün denendiği GPT-2, Pythia ve OPT birer araştırma modeli. Bugünün güvenlik eğitimli sohbet botlarında aynı eşiğin tutup tutmadığı henüz gösterilmiş değil. Yine de sıranın içerik kadar belirleyici çıkması, mesajları tek tek süzen filtrelerin neden yetmediğini gösteriyor.