
ColibrìNedir?
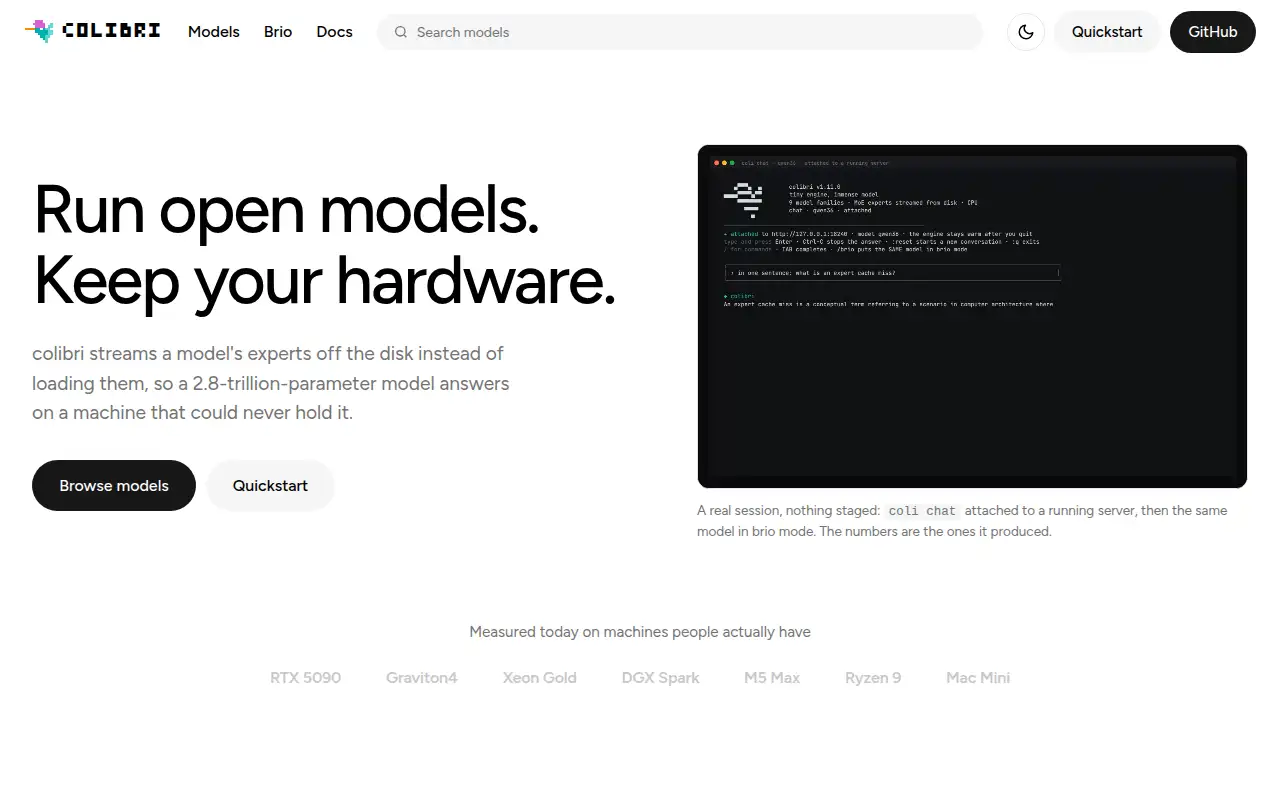
AI Asistan744 milyar ile 2,8 trilyon parametre arası dev açık modelleri, uzmanları diskten okuyarak sıradan bilgisayarda çalıştıran açık kaynak çıkarım motoru.
 Mindi Ne Düşünüyor?
✅ 744 milyarlık GLM-5.2'yi 16 GB RAM'le bile çalıştırabiliyor: uzmanları diskten okuyor, sık çalışanları kullandıkça hızlı belleğe alıyor. Brio moduyla seçenekli sorularda metin üretmeden karar verdirebiliyorsun.
⚠️ Hız diskine bağlı; sıradan donanımda saniyede 1-2 token, GLM-5.2 paketi tek başına 372 GB.
🔀 ollama belleğe sığan modellerde çok daha hızlı ve kolay; Colibrì sığmayanlar için var.
Mindi Skoru

Yorum bırakmak için giriş yapmanız gerekiyor.
Colibrì Hakkında
✓ Colibrì Kimler İçin?
✕ Colibrì Kimler İçin Uygun Değil?
Colibrì Detaylı İnceleme
Colibrì, normalde veri merkezi donanımı isteyen dev açık modelleri sıradan bir bilgisayarda çalıştırmayı hedefleyen açık kaynak bir çıkarım motoru. Listede 744 milyar parametreli GLM-5.2'den 2,8 trilyonluk Kimi K3'e kadar modeller var. İşin sırrı şu: bu modellerin çoğu MoE (uzman karışımı) mimarisinde, yani her token'da parametrelerin sadece küçük bir kısmı devreye giriyor. GLM-5.2'de 744 milyarın yaklaşık 40 milyarı aktif. Colibrì modeli belleğe sığdırmaya çalışmıyor; her seferinde çalışan sabit kısmı RAM'de tutuyor, uzmanları diskte bırakıp gerektikçe okuyor.
Proje, Vincenzo Fornaro'nun 12 çekirdekli, 25 GB RAM'li bir dizüstünde tek başına başlattığı bir deney olarak doğdu. Bugün GitHub'da 37 bini aşan yıldızı var, Eylül 2026'nın son haftasında haftalık trend listesine girdi ve hız ölçümlerinin çoğu artık topluluğun kendi makinelerinden geliyor. Lisansı Apache 2.0.
Motorun kendisi saf C ile yazılmış ve hiçbir kütüphaneye bağımlı değil; Python sadece başlatıcı, API ağ geçidi ve tek seferlik model dönüştürme için kullanılıyor. GPU zorunlu değil. Varsa CUDA, Vulkan veya Apple Silicon'da Metal üzerinden hızlandırıyor; modelin cevabı değişmiyor, sadece hız değişiyor.
Temel Özellikler
Tek bellek hiyerarşisi. VRAM, RAM ve NVMe diski aynı modelin katmanları gibi kullanıyor. Hızlı bellek azsa model yavaşlıyor ama hassasiyeti düşürülmüyor; proje bunu "modeli sessizce değiştirmeme" kuralı olarak koymuş.
Kullandıkça hızlanan önbellek. Motor senin işlerinde hangi uzmanların çalıştığını kaydediyor ve en sık kullanılanları hızlı belleğe sabitliyor. Bir sonraki katmanın uzmanlarını önceden yüklemek için yönlendiriciyi de bir adım önden çalıştırıyor.
Dokuz model ailesi. GLM-5.2/5.3, GLM-5.3-Flash, Inkling, Kimi K3, DeepSeek V4 Flash, DeepSeek V4.1 Flash, Qwen3.8-Flash-Next, Qwen3.6 35B-A3B ve OLMoE destekleniyor. Hepsi aynı coli chat, coli serve ve coli web komutlarıyla çalışıyor.
OpenAI uyumlu API ve web paneli. coli serve ile başka uygulamaların bağlanabileceği bir API açıyorsun. coli web ile sohbet, canlı metrikler ve hangi uzmanın o an çalıştığını gösteren bir panel geliyor.
Brio modu. Modele metin yazdırmak yerine seçenek veriyorsun ("birleştir / değişiklik iste / kapat" gibi). Model her seçeneğin olasılığını ve ne kadar emin olduğunu gösteren bir değer döndürüyor, listenin dışına çıkamıyor. Projenin Qwen3.6 ile yaptığı ölçümlerde bu yol, aynı cevabı metin olarak ürettirmeye göre 2,4 ile 5,7 kat arası hızlı çıkmış.
Birden fazla SSD. Modelin bir kopyasını ikinci bir diske koyarsan motor iki diskten paralel okuyabiliyor. İki bağımsız NVMe ile %37,5 hız artışı ölçülmüş.
Ne Kadar Hızlı?
Beklentini doğru kur: Colibrì dev modeli çalıştırmayı mümkün kılıyor, ChatGPT hızında değil. Projenin kendi ölçümleri (GLM-5.2, int4):
| Donanım | Üretim hızı |
|---|---|
| 6 × RTX 5090, tüm uzmanlar bellekte | 5,8–6,8 token/sn |
| 128 GB RAM'li, GPU'suz masaüstü | ~1,8 token/sn (önbellek ısınmışken) |
| Tek RTX 5070 Ti | 1,07 token/sn |
| 25 GB RAM'li geliştirme makinesi | 0,05–0,1 token/sn (soğuk başlangıç) |
Daha küçük Qwen3.6 35B-A3B modeli iki adet 8 GB'lık ekran kartında saniyede 10 token civarına çıkıyor. Belleğe sığan modellerde hangisinin senin donanımında rahat çalışacağını görmek için Hangi Yapay Zeka Çalışır aracına bakabilirsin.
Kullanım Senaryoları
Veriyi dışarı çıkarmadan büyük model. Model dosyaları makineden çıkmıyor. Buluta gönderemeyeceğin belgeleri frontier sınıfı açık bir modele okutmanın yollarından biri.
Bekleyebilen toplu işler. Gece çalışan sınıflandırma, etiketleme ve özetleme işlerinde saniyede bir iki token çoğu zaman yetiyor. Brio modu özellikle karar verme tipindeki işlerde öne çıkıyor.
Öğrenmek ve deney yapmak. Dev bir MoE modelin içinde hangi uzmanın hangi konuda çalıştığını canlı izleyebildiğin araç sayısı az. Proje katkıyı da ölçüm verisi üzerinden istiyor.
Nasıl Başlanır?
GitHub'daki Releases sayfasından Windows, macOS veya Linux arşivini indirip açıyorsun. Derleyici gerekmiyor, sadece Python 3 kurulu olmalı. Asıl iş model tarafında: GLM-5.2 için Hugging Face'teki hazır dönüştürülmüş paket yaklaşık 372 GB, GLM-5.3 için 419 GB. Daha küçük bir modelle başlamak istersen Qwen3.6 paketi 20 GB civarında ve 24 GB RAM istiyor. Sonra coli chat ile sohbeti açıyor, coli plan ile modelin VRAM, RAM ve disk arasında nasıl dağıtılacağını görüyor, coli tune ile makinene uygun ayarı ölçtürüyorsun.
Dikkat Edilecekler
- Hız garantisi yok, proje bunu açıkça söylüyor. Yavaş bir diskte saniyede bir token'ın altında kalırsın.
- Hızlı ve boş NVMe alanı şart: büyük modeller yüzlerce GB, Kimi K3 yaklaşık 1,6 TB.
- Arayüz ve dokümanlar İngilizce. Türkçe cevap kalitesi motora değil, seçtiğin modele bağlı.
- Komut satırı ağırlıklı bir araç; ollama veya LM Studio'daki gibi tıkla-indir model kütüphanesi yok.
- Proje kendini hem çalışan bir motor hem de açık bir araştırma platformu olarak tanımlıyor; Metal arka ucu ve çoklu makine (küme) modu gibi parçalar deneysel.
Fiyatlandırma
| Plan | Ne kadar | Ne içeriyor |
|---|---|---|
| Colibrì | Ücretsiz (Apache 2.0) | Motorun tamamı; API, web paneli ve model dönüştürme araçları dahil |
Motor ücretsiz, desteklenen açık ağırlıklı modelleri indirmek de ücretsiz. Asıl maliyet donanımda: önce hızlı ve büyük bir NVMe disk, sonra RAM.