Nvidia, gerçek zamanlı konuşmacı tanıyan ücretsiz 100M parametreli modelini yayınladı: sekiz kişiye kadar ayrıştırıyor

*Yukarıdaki butona tıkla ve ekle. Yapay zeka gelişmelerini Google’da her zaman üstte gör.
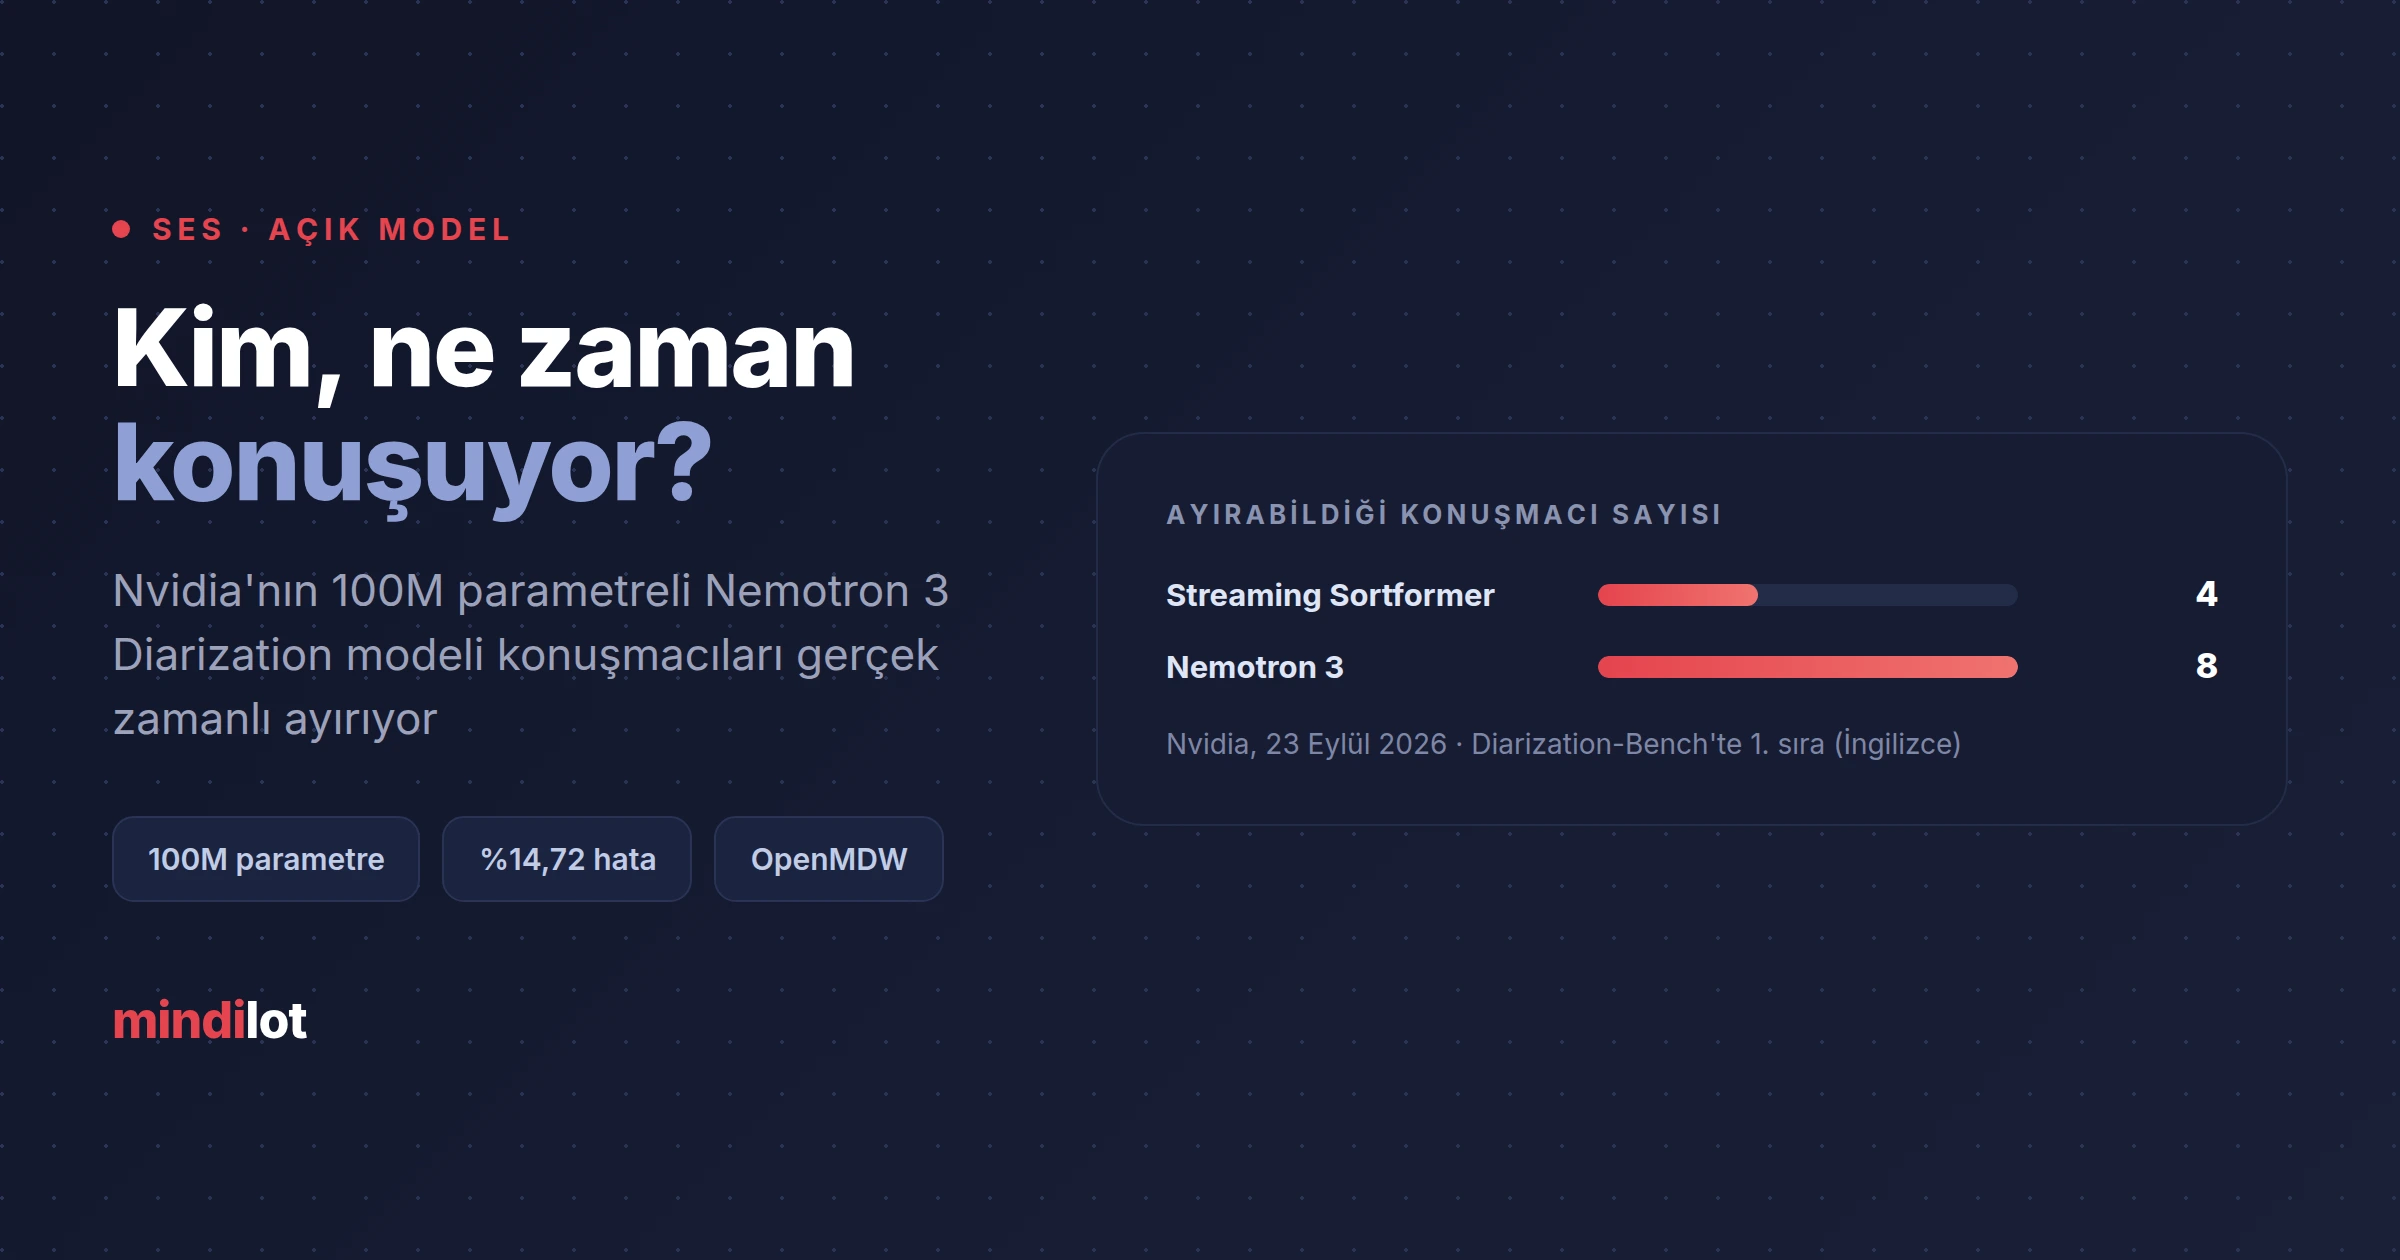
Nvidia, bir konuşmada kimin ne zaman konuştuğunu gerçek zamanlı belirleyen açık ağırlıklı Nemotron 3 Diarization modelini yayınladı. Yaklaşık 100 milyon parametreli model, VoiceArena'nın Diarization-Bench tablosunda %14,72 hata oranıyla birinci sırada.
Nvidia, bir konuşmada kimin ne zaman konuştuğunu gerçek zamanlı belirleyen açık ağırlıklı Nemotron 3 Diarization modelini yayınladı. Yaklaşık 100 milyon parametreli model, VoiceArena'nın Diarization-Bench tablosunda %14,72 hata oranıyla birinci sırada.
Sekiz konuşmacıya kadar, üst üste binen konuşmalar dahil
Şirketin Hugging Face blogundaki Model Cardi Bir modelin eğitimi, sınırları ve kullanım koşullarını anlatan teknik belge. bilgilerine göre model sekiz konuşmacıya kadar ayrıştırma yapıyor ve insanların birbirinin sözünü kestiği anları da işaretliyor. Hem canlı akışta hem kayıtlı seste çalışıyor; gecikme ayarı 0,32 saniyeye kadar iniyor. Uzun kayıtları parçalar halinde işlerken konuşmacılar parçadan parçaya karışmasın diye onları geliş sırasına göre tutuyor. Bu yaklaşım Nvidia'nın dört konuşmacıyla sınırlı önceki Streaming Sortformer modelinden geliyor.
Kendi GPU'nda çalışabiliyor
100 milyon parametre bu görev için küçük bir boyut. Model, Linux üzerinde Ampere, Hopper ya da Blackwell mimarili bir Nvidia GPU için tasarlanmış. Open-WeightsiAğırlıkları indirilebilen, kendi sunucunda çalıştırılabilen model. olduğu için toplantı ve çağrı kayıtlarını buluta göndermeden işlemek mümkün. Lisansı OpenMDW 1.1 ve ticari kullanıma izin veriyor.
Sıralama İngilizce üzerinden
Diarization-Bench sonucu 139 İngilizce konuşma üzerinden ölçülüyor. Eğitim verisinde 21 dil var, ancak diğer dillerdeki başarı için ayrı bir tablo yayınlanmadı.
Nvidia'nın model serisinin geri kalanını Nemotron 3 serisini karşılaştırdığımız rehberde anlatmıştık.
100 milyon parametrenin tek başına haber olması, ses tarafında işin nereye gittiğini gösteriyor: bulut API'sine bağlı ağır çözümler yerine kendi donanımında çalışan küçük modeller. Diarization, transkript araçlarının en görünmez ama en çok şikâyet edilen parçasıydı. Birincilik İngilizce kayıtlarda geldi; Türkçe ve gürültülü kayıtlarda nasıl davrandığı henüz ölçülmüş değil.